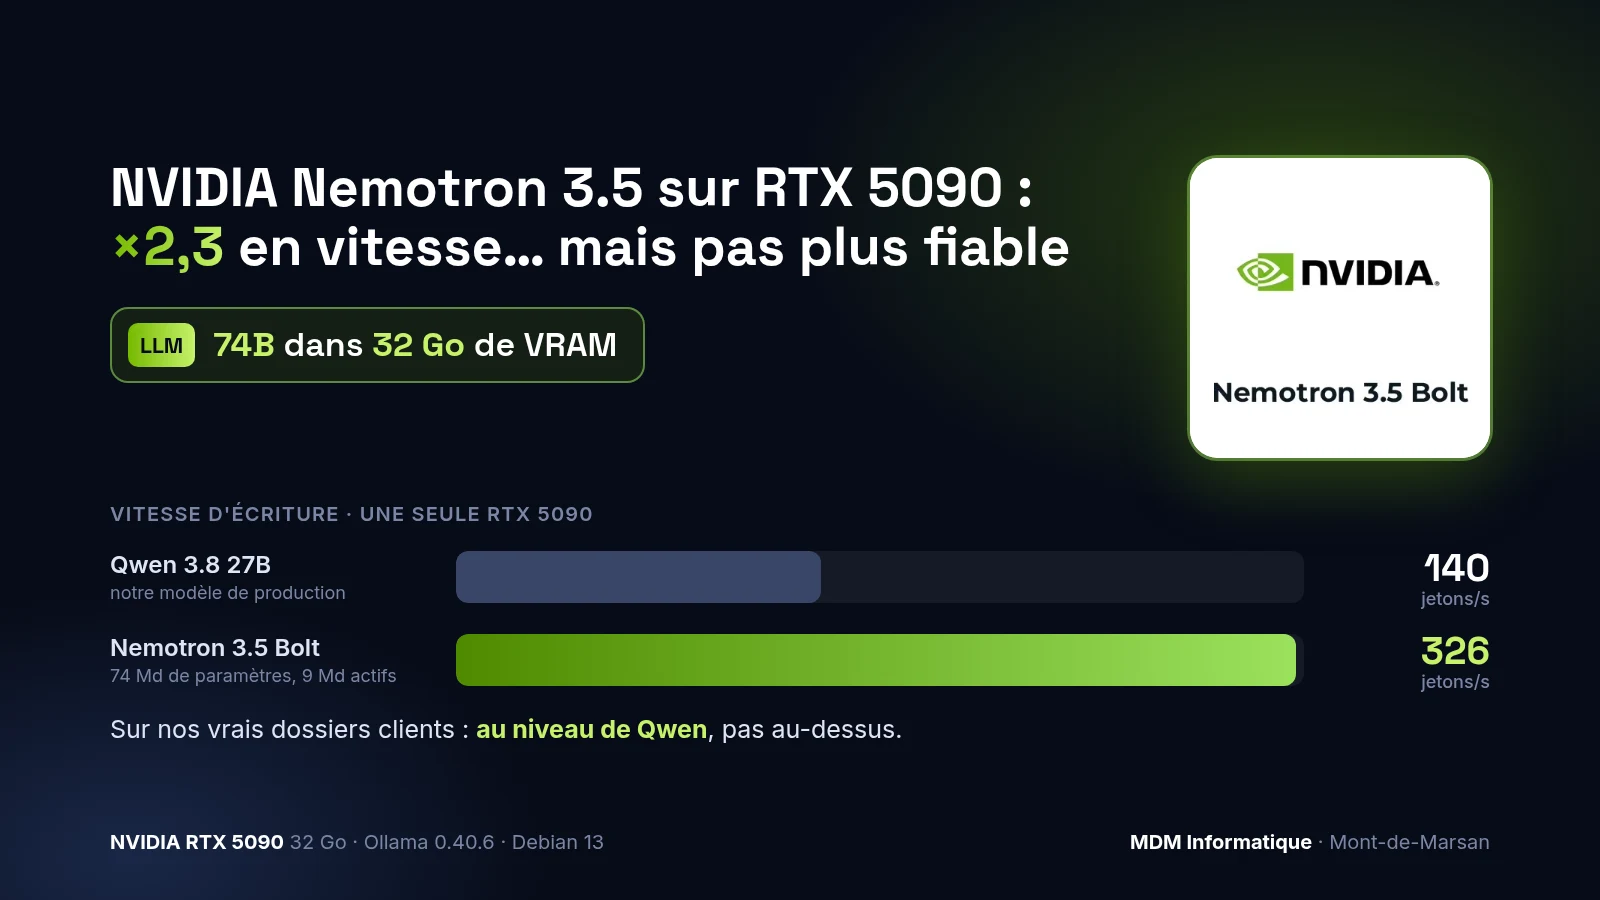
NVIDIA vient de sortir Nemotron 3.5, une famille de modèles d'IA ouverts, dont une version taillée pour les PC équipés d'une carte graphique RTX. Chez MDM Informatique, on l'a installé sur un de nos serveurs IA, équipé d'une NVIDIA RTX 5090, dans les Landes, et on l'a comparé à Qwen 3.8, le modèle que nous utilisons tous les jours. Résultat : Nemotron écrit plus de deux fois plus vite. Mais sur nos vrais dossiers clients, il n'est pas plus fiable. Voici notre test complet, chiffres et images à l'appui.
Tests effectués le 21/10/2026 sur un Intel Core i7-14700 / 64 Go de RAM / Debian 13, avec une NVIDIA GeForce RTX 5090 (32 Go) et Ollama 0.40.6.
Nemotron 3.5 : ce que NVIDIA a sorti en octobre 2026
Le 15 octobre 2026, NVIDIA a présenté deux nouveaux modèles de la famille Nemotron. La version Bolt est sortie le lendemain, le 16 octobre 2026 :
- Nemotron 3.5 Super VL : 120 milliards de paramètres, capable de lire du texte et des images. Il vise les stations de travail et les serveurs : il ne tient pas sur une seule carte de 32 Go.
- Nemotron 3.5 Bolt 74B-A9B : la version « bureau ». Sur ses 74 milliards de paramètres, seuls 9 milliards travaillent pour chaque mot produit (on parle de modèle à mélange d'experts, ou MoE). NVIDIA l'a compressé en 2 bits pour qu'il tienne dans 24 Go de mémoire.
Bolt sait lire des images, appeler des outils et « réfléchir » avant de répondre. Il accepte jusqu'à 262 000 jetons de contexte, soit plusieurs centaines de pages. Il embarque aussi un petit modèle « brouillon » qui devine les mots suivants pour accélérer l'écriture. Il est distribué sous licence ouverte (OpenMDW 1.1) et s'installe en une commande avec Ollama, à partir de la version 0.40.5 :
ollama pull nemotron-3.5-bolt:74b-a9bC'est ce modèle que nous avons testé, face à Qwen 3.8 27B (quantification Q6_K, 23 Go), notre modèle de production. Qwen 3.8 est un modèle « dense » : ses 27 milliards de paramètres travaillent à chaque mot. Il utilise lui aussi une technique d'accélération, la tête MTP, qui propose 4 jetons d'avance : nous l'avions activée et mesurée dans notre test d'Ollama 0.35 sur RTX 5090.
| Fiche technique | Qwen 3.8 27B | Nemotron 3.5 Bolt |
|---|---|---|
| Paramètres | 27 milliards, tous actifs | 74 milliards, 9 milliards actifs |
| Compression | environ 6 bits par poids (Q6_K) | 2 bits pour les experts (IQ2_XXS) |
| Taille du fichier | 23 Go | 24 Go |
| Contexte maximal | 131 000 jetons (réglage de notre serveur) | 262 000 jetons |
| Accélération | tête MTP, 4 jetons proposés d'avance | modèle brouillon intégré, 7 jetons proposés d'avance |
| Images, outils, réflexion | oui | oui |
Comment fonctionne un modèle MoE comme Nemotron
Un modèle classique, dit « dense », comme Qwen 3.8 27B, fait travailler tous ses paramètres pour chaque jeton qu'il écrit : 27 milliards de calculs, mot après mot. Un modèle à mélange d'experts (MoE, pour Mixture of Experts) fonctionne autrement :
- Des experts : une grande partie du réseau est découpée en de nombreux petits sous-réseaux. Pendant l'entraînement, chacun s'est spécialisé sur certains types de contenus.
- Un aiguilleur : pour chaque jeton, un petit routeur interne choisit les quelques experts les plus utiles. Les autres restent au repos.
- Le résultat : Nemotron Bolt dispose des connaissances de 74 milliards de paramètres, mais n'en fait calculer qu'environ 9 milliards par jeton. Il a la vitesse d'un petit modèle et la culture d'un grand.
La contrepartie : même au repos, tous les experts doivent rester en mémoire. Pour faire tenir 74 milliards de paramètres dans 24 Go, NVIDIA les a compressés en 2 bits. Une compression aussi forte peut coûter un peu de précision, ce qui peut expliquer la TVA mal lue de notre test n° 2.
Nemotron 3.5 Bolt est aussi un modèle hybride. Une partie de ses couches sont de type Mamba : au lieu de relire tout le texte à chaque mot, elles en gardent un résumé compact. C'est ce qui lui permet d'accepter 262 000 jetons de contexte tout en occupant moins de mémoire que Qwen (26,5 Go contre 29,2 Go). Les autres couches restent des couches d'« attention », celles des modèles Transformer classiques.
Test n° 1 : la vitesse d'écriture
Même machine, mêmes réglages, mêmes tâches : rédiger un e-mail client d'environ 300 mots, écrire une fonction Python et extraire des informations en JSON à partir d'un message. Chaque tâche est lancée deux fois, à deux températures différentes (0 et 0,7), et on retient la médiane. On mesure aussi la lecture d'un long document de 23 000 jetons. La réflexion est désactivée pour les deux modèles, comme dans nos usages de production.
| Mesure | Qwen 3.8 27B | Nemotron 3.5 Bolt | Écart |
|---|---|---|---|
| Écriture (température 0) | 140 jetons/s | 326 jetons/s | × 2,3 |
| Écriture (température 0,7) | 136 jetons/s | 330 jetons/s | × 2,4 |
| Lecture d'un long document | 2 938 jetons/s | 3 273 jetons/s | + 11 % |
| Écriture juste après ce long document | 134 jetons/s | 304 jetons/s | × 2,3 |
| Mémoire de la carte occupée | 29,2 Go | 26,5 Go | plus léger |
Le détail par tâche montre que l'écart dépend de ce que l'on demande :
| Tâche | Qwen 3.8 : vitesse et durée | Nemotron : vitesse et durée | Écart |
|---|---|---|---|
| E-mail client de 300 mots | 106 jetons/s · 4,8 à 4,9 s | 217 jetons/s · 1,7 à 2,6 s | × 2,0 |
| Fonction Python (600 jetons) | 152 jetons/s · 3,8 à 4,5 s | 332 jetons/s · environ 2 s | × 2,2 |
| Extraction en JSON | 139 jetons/s · 2,3 à 2,5 s | 373 jetons/s · 0,7 à 0,9 s | × 2,7 |
| Lecture de 23 000 jetons | 8,7 à 9,1 s | 7,4 à 7,5 s | + 11 % |
Trois raisons expliquent cette vitesse :
- Peu de calcul par mot : 9 milliards de paramètres actifs au lieu de 27.
- Des poids très compressés : moins de données à lire en mémoire pour chaque mot.
- Un brouillon plus ambitieux : il propose 7 jetons d'avance, contre 4 pour Qwen. Le premier est accepté dans 81 % des cas (82 % pour Qwen), et en moyenne 4,1 jetons sont validés d'un coup, contre 3,2 pour Qwen. Plus le texte est prévisible, comme du JSON, plus le brouillon tombe juste.
Un bémol : d'une série de mesures à l'autre, Nemotron varie davantage que Qwen. Nous avons relevé entre 270 et 330 jetons/s, sans trouver de cause, quand Qwen restait stable à 1 ou 2 % près. Retenez un ordre de grandeur : 2 à 2,4 fois plus rapide.
Test n° 2 : la lecture d'images
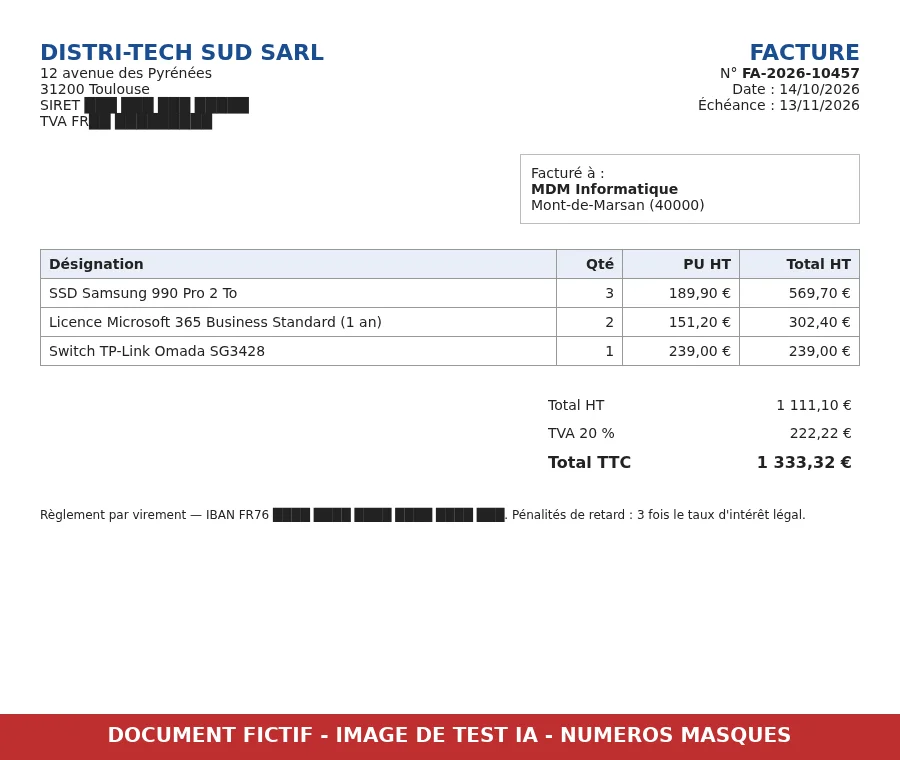
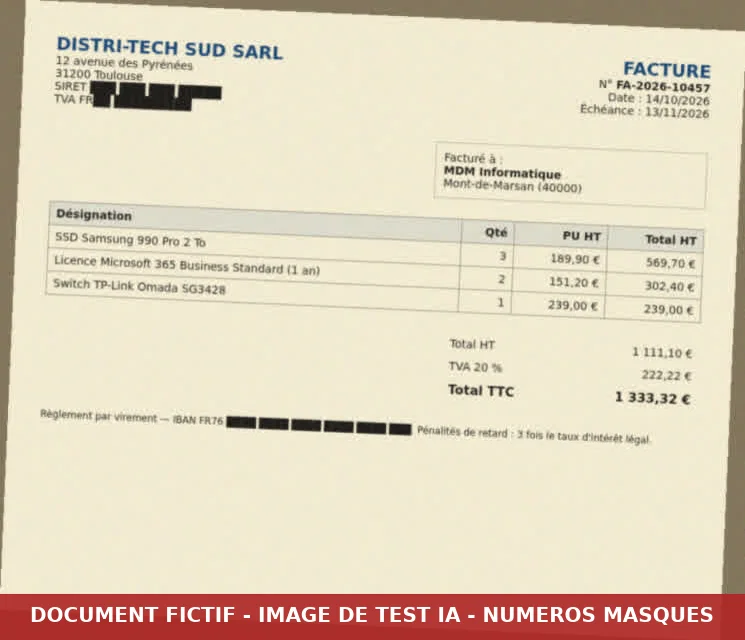
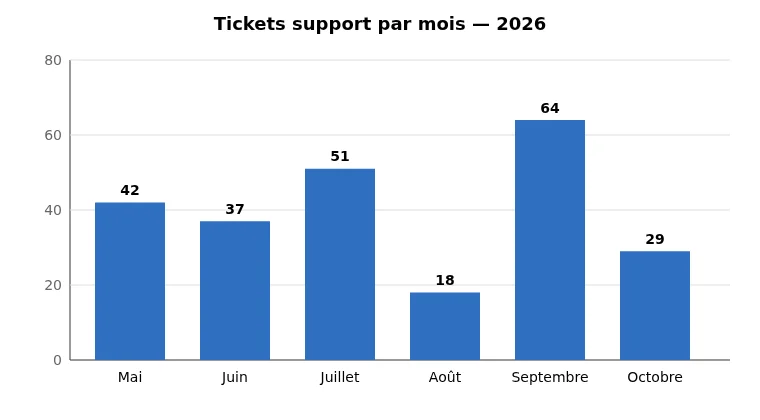
Les deux modèles lisent les images. Nous leur avons soumis cinq images dont nous connaissions la bonne réponse, avec la même consigne pour chacun, la réflexion désactivée et la température à 0. Chaque champ attendu vaut un point.
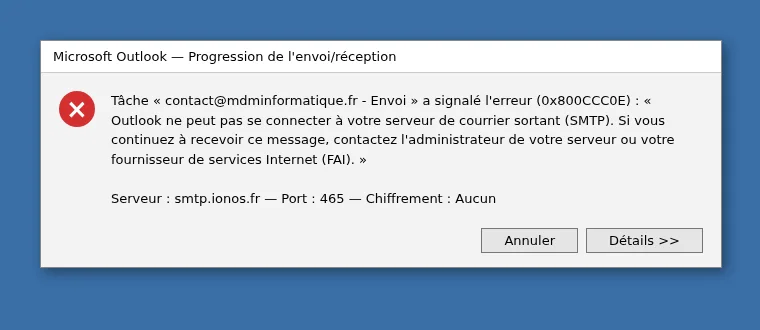
Sur cette capture, voici la cause probable que chacun a donnée :
- Qwen 3.8 : « Le serveur SMTP IONOS exige une connexion sécurisée (SSL/TLS) sur le port 465, mais le client est configuré sans chiffrement. » C'est le bon diagnostic.
- Nemotron : « Le serveur de courrier sortant refuse la connexion, probablement en raison d'une authentification incorrecte ou d'une configuration de chiffrement inadéquate. » Il propose d'abord de vérifier le mot de passe, et ne parle du SSL qu'en troisième étape.
| Image | Qwen 3.8 : score · durée | Nemotron : score · durée |
|---|---|---|
| Facture nette | 20/20 · 4,2 s* | 20/20 · 5,8 s* |
| Facture « photographiée » | 20/20 · 2,4 s | 19/20 · 1,2 s |
| Capture d'erreur | 6/6, bonne cause · 2,0 s | 6/6, cause vague · 1,1 s |
| Graphique | 9/9 · 1,0 s | 9/9 · 0,6 s |
| Photo produit | juste et détaillée · 2,9 s | juste, plus courte · 1,6 s |
| Total | 55/55 · 8,2 s** | 54/55 · 4,5 s** |
* La première image de chaque série inclut le démarrage du module de vision. ** Durée totale des 4 dernières images.
Deux détails pratiques en plus. Les deux modèles « voient » une image avec à peu près le même nombre de jetons, environ 2 100 pour une photo en haute définition. Et quand on demande « uniquement du JSON », Nemotron renvoie du JSON brut, directement utilisable par un programme, alors que Qwen l'entoure de balises qu'il faut retirer. Une erreur sur un montant de TVA reste rédhibitoire en comptabilité : quel que soit le modèle, gardez un contrôle automatique HT + TVA = TTC.
Test n° 3 : un vrai dossier client, les comptes rendus de chantier
Les bancs de test, c'est bien. Un usage réel, c'est mieux. Pour une entreprise du BTP cliente, près de Capbreton, nous avons construit un outil qui lit automatiquement les comptes rendus de réunion de chantier reçus par mail. Ce sont des PDF de 10 à 40 pages, à raison de 200 à 315 par mois. La question posée à l'IA est simple et lourde de conséquences : l'entreprise est-elle convoquée à la prochaine réunion, quand et où ? Une réunion obligatoire manquée peut coûter des pénalités.
Avant l'outil, le secrétariat lisait chaque compte rendu à la main : ouvrir le PDF, trouver le tableau de convocation, retrouver la ligne de l'entreprise, vérifier la case, puis reporter la date dans l'agenda. Comptez environ 5 minutes par document, soit 17 à 26 heures par mois. Aujourd'hui, la machine le fait en 15 secondes environ par document, et l'équipe ne contrôle plus que les cas douteux.
Le circuit est le suivant :
- La boîte mail de l'entreprise est relevée toutes les 15 minutes.
- Le texte de chaque PDF est extrait page par page ; les pages scannées passent par une reconnaissance de caractères (OCR).
- Le modèle reçoit une consigne précise : « obligatoire » si la case est cochée, « non convoqué » si la colonne de convocation est vide sur la ligne de l'entreprise, « à confirmer » dans le doute. Il doit citer la phrase du document qui justifie sa réponse.
- Le résultat s'affiche dans l'outil (convocations, calendrier, carte), et un rappel part par mail à 7 h et à 17 h.
Nous avons rejoué 40 comptes rendus réels reçus du 14 au 16 octobre, dont 12 avec des pages scannées, avec les deux modèles, par exactement le même chemin que la production. La référence est la lecture de Claude Sonnet 5.5, un modèle en ligne qui lit le PDF complet. Pour mesurer le « bruit », Qwen a passé le test deux fois, à deux jours d'écart.
| 40 comptes rendus réels | Qwen 3.8 | Nemotron 3.5 Bolt |
|---|---|---|
| Réunions obligatoires manquées | 0 | 0 |
| Statut de convocation identique à la référence | 58 à 62 % | 57 % |
| Fausses alertes « présence obligatoire » | 6 à 7 | 9 |
| Date de la prochaine réunion juste | 95 à 98 % | 95 % |
| Documents sans réponse exploitable | 0 | 3 |
| Temps médian par compte rendu | 16,0 s | 11,1 s |
| Temps moyen par compte rendu | 16,3 s | 13,9 s (− 15 %) |
D'un passage à l'autre, Qwen ne donne le même statut que pour 28 comptes rendus sur 40. Les quelques points d'écart entre les deux modèles sont donc du même ordre que la variation d'un même modèle d'un jour à l'autre.
Ici, l'avantage de vitesse fond à 15 %. Le détail du temps de calcul, sur les 37 comptes rendus réussis par les deux modèles, montre pourquoi :
| Sur 37 comptes rendus | Qwen 3.8 | Nemotron 3.5 Bolt |
|---|---|---|
| Temps total | 10 min 04 s | 8 min 35 s |
| dont lecture des documents | 2 min 48 s | 3 min 30 s |
| dont écriture des réponses | 6 min 52 s | 4 min 48 s |
| Vitesse de lecture | 4 044 jetons/s | 3 089 jetons/s |
| Vitesse d'écriture | 136 jetons/s | 296 jetons/s |
| Longueur moyenne de la réponse | 1 567 jetons | 1 987 jetons |
Chaque compte rendu, c'est en général 14 500 jetons à lire, et jusqu'à 39 000. Sur la lecture, Nemotron est 24 % plus lent que Qwen. Avec un format de réponse imposé, il écrit aussi 27 % de texte en plus pour remplir le même formulaire. Enfin, il a « bouclé » sur trois documents : il a répété sa réponse jusqu'à dépasser la limite fixée, deux essais de suite.
Ramené à l'usage, l'écart est minime. Un jour ouvré de 10 à 15 comptes rendus représente 3 à 4 minutes de calcul avec l'un comme avec l'autre. Sur un mois, il faut compter 56 à 88 minutes pour Qwen et 52 à 82 minutes pour Nemotron, contre 17 à 26 heures de lecture humaine économisées.
Le vrai progrès : montrer le tableau en image
En regardant les erreurs de près, une surprise : les deux modèles se trompaient sur les mêmes comptes rendus, et de la même façon. Ils disaient « obligatoire » là où l'entreprise n'était pas convoquée. Les faire voter ensemble n'aidait donc pas : quand ils étaient d'accord, ils avaient raison à 62 %, à peine plus que Qwen seul. Le coupable n'était pas le modèle, mais ce qu'on lui donnait à lire. Quand on transforme un PDF en texte, les croix d'un tableau sont conservées, mais leur colonne est perdue.
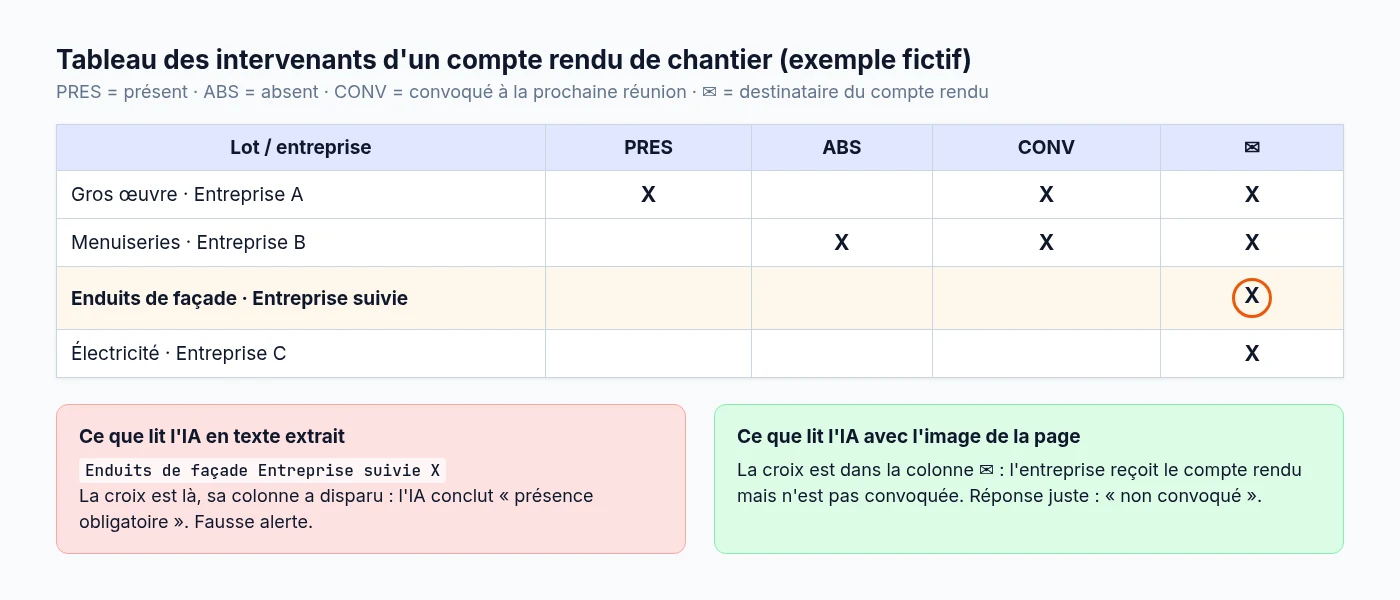
Nous avons donc ajouté une étape. L'outil repère la page du tableau où figure l'entreprise, à partir des contacts et des titres de colonnes, abréviations comprises. Si les colonnes n'y sont pas titrées, il prend aussi la page précédente, où le tableau commence. Ces 1 à 3 pages partent en image au modèle, en plus du texte, avec une consigne courte : « repère d'abord les titres des colonnes, puis la ligne de l'entreprise ; une croix de présence ou de diffusion n'est pas une convocation ». Cela ajoute environ 2 200 jetons par page.
| 40 comptes rendus | Qwen, texte seul | Nemotron, texte seul | Qwen + images | Nemotron + images |
|---|---|---|---|---|
| Réponses exploitables | 40/40 | 37/40 | 40/40 | 40/40 |
| Statut identique à la référence | 58 % | 57 % | 68 % | 62 % |
| Réunions obligatoires manquées | 0 | 0 | 0 | 0 |
| Fausses alertes « présence obligatoire » | 7 | 9 | 5 | 3 |
| Cas « à confirmer » à vérifier par l'équipe | 5 | 3 | 3 | 8 |
| Dates de prochaine réunion fausses | 2 | 2 | 1 | 3 |
| Temps médian par compte rendu | 16,0 s | 11,1 s | 18,4 s | 14,2 s |
Les deux modèles progressent nettement. Nemotron devient le plus prudent : il fait le moins de fausses alertes, et ses justifications deviennent vérifiables, par exemple « la ligne de l'entreprise ne porte aucune croix dans les colonnes PRES, ABS ou CONV, alors que d'autres entreprises sont marquées ». Qwen devient le plus juste : il est le plus souvent d'accord avec la référence, se trompe moins sur les dates et laisse moins de vérifications à faire. Or une date fausse peut faire manquer une réunion, alors qu'une fausse alerte ne coûte qu'un déplacement ou une vérification.
Pour ce client, nous avons donc mis en production Qwen 3.8 avec les images du tableau. Le modèle en ligne reste le moteur principal, et le modèle local prend automatiquement le relais si le crédit de l'API est épuisé. Ce secours a été testé sur une copie de la base avant d'être activé.
Test n° 4 : la qualification des appels téléphoniques d'un client
Chez un de nos clients qui s'est doté de notre solution IA mdmstudio.ai, chaque appel du standard est enregistré, transcrit par Whisper, puis qualifié par l'IA locale en deux passes. La première nettoie le texte (ponctuation, termes métier). La seconde donne la catégorie (support, commercial, prospection, réclamation, rendez-vous, renseignement, autre), la direction, le sentiment, la nature du client, un résumé et les actions à faire. Le résultat alimente son tableau de bord et crée automatiquement les demandes de devis. L'outil en a qualifié 338 du 1er au 20 octobre, soit environ 17 par jour.
C'est typiquement un travail de « réponse rapide » : un texte court à lire, une réponse à écrire. Nous avons rejoué 30 appels réels d'octobre, de 300 à 5 500 caractères, couvrant toutes les catégories, avec exactement les consignes de production.
| 30 appels réels | Qwen 3.8 | Nemotron 3.5 Bolt |
|---|---|---|
| Qualifications valides | 30/30 | 30/30 |
| Temps médian par appel (2 passes) | 4,2 s | 2,2 s |
| dont nettoyage du texte | 2,3 s | 1,1 s |
| dont qualification | 1,8 s | 1,0 s |
| Appel le plus long à traiter | 11,1 s | 6,7 s |
| Vitesse d'écriture | 173 jetons/s | 381 jetons/s |
| Texte nettoyé : longueur conservée | 100 % | 100 % |
| Même direction / sentiment / nature du client que la production | 97 % / 90 % / 100 % | 97 % / 87 % / 87 % |
| Catégorie juste sur les 11 appels où ils divergent | 8 | 0 (3 cas discutables) |
Les deux modèles ne donnent la même catégorie que pour 19 appels sur 30. Nous avons relu les 11 autres un par un, à partir des définitions de la consigne :
- un message d'attente ou un répondeur : Qwen dit « autre », Nemotron « renseignement » ;
- une erreur de numéro : Qwen dit « autre », Nemotron « prospection » ;
- un client qui finalise l'achat d'un ordinateur : Qwen dit « commercial », Nemotron « support » ;
- une erreur sur l'intitulé d'une facture : Qwen dit « réclamation », Nemotron « support ».
Côté résumés, les deux se valent : factuels, en 2 ou 3 phrases. Nemotron a même mieux compris un appel : le client apportait son PC pour l'intervention, alors que Qwen avait écrit qu'il venait le récupérer. Qwen est plus juste sur les actions à faire : Nemotron liste parfois ce qui vient d'être fait, comme « informer le client » juste après lui avoir laissé un message.
Pour la qualification en tâche de fond, nous gardons Qwen chez ce client. Une seconde de plus par appel ne se voit pas : c'est 1 min 20 s de calcul par jour au lieu de 45 s. Une catégorie fausse, en revanche, se voit sur le tableau de bord et dans les devis automatiques. Nemotron a du sens là où l'on attend la réponse en direct, avec une consigne écrite pour lui.
Nemotron demande des réglages, et c'est voulu
Qwen 3.8 se comporte comme un assistant prêt à l'emploi. Nemotron est pensé autrement : NVIDIA présente la famille Nemotron comme une base ouverte, publiée avec ses poids, ses jeux de données et ses recettes d'entraînement, pour que chaque entreprise l'adapte à son usage. Si Nemotron a besoin d'être réglé, c'est donc le but.
Nos tests le confirment. Avec des consignes écrites et réglées pour Qwen, Nemotron fait moins bien. Dès qu'on adapte ce qu'on lui donne, il progresse : avec les pages du tableau en image, ses fausses alertes passent de 9 à 3. Les leviers, du plus simple au plus poussé :
- Une consigne écrite pour lui, avec des définitions et des exemples pour chaque catégorie.
- Ses propres réglages : NVIDIA le livre avec une température de 1 et un top_p de 0,95, alors que nos chaînes imposent une température de 0,1 à 0,6.
- Une limite de réponse adaptée et des garde-fous contre les répétitions, pour éviter les boucles vues sur certains comptes rendus.
- Le mode réflexion, à doser selon la tâche.
- Un réentraînement sur vos propres données (fine-tuning), que sa licence ouverte autorise : par exemple sur les centaines de comptes rendus déjà analysés.
Notre verdict
- Nemotron 3.5 Bolt est rapide, mais au niveau de Qwen 3.8, pas au-dessus. Il écrit 2 à 2,4 fois plus vite. Sur nos dossiers réels, il n'est pas plus fiable tel quel : il demande à être réglé, et c'est sa vocation.
- Il est fait pour la réponse rapide : assistant conversationnel, analyse et résumé d'appels, extraction courte. Son avantage fond quand il faut lire de longs documents dans un format strict.
- Le plus gros progrès ne vient pas du modèle, mais de ce qu'on lui montre. En lui donnant l'image des tableaux, on a fait passer l'accord de 58 à 68 % avec le même Qwen.
- Une IA locale de ce niveau tient sur une seule carte de 32 Go, installée dans l'entreprise (voir notre guide pour choisir son serveur). Les documents ne sortent pas de vos murs et chaque traitement ne coûte que l'électricité. Pour une entreprise française de 1 à 2 millions d'euros de chiffre d'affaires, le coût d'une telle machine reste acceptable au regard des heures gagnées.
- Le gain le plus important est humain : pour l'entreprise du BTP près de Capbreton, ce sont 17 à 26 heures de lecture par mois rendues à une petite équipe, quel que soit le modèle choisi.
Le résultat de nos tests : une équipe de modèles plutôt qu'un seul
Aucun modèle ne gagne partout. Qwen 3.8 est le plus fiable pour lire et classer. Nemotron Bolt est le plus rapide pour répondre. Un modèle en ligne reste utile pour les cas les plus difficiles. Plutôt que de choisir, l'architecture vers laquelle nous allons confie chaque demande au modèle qui la traite le mieux :
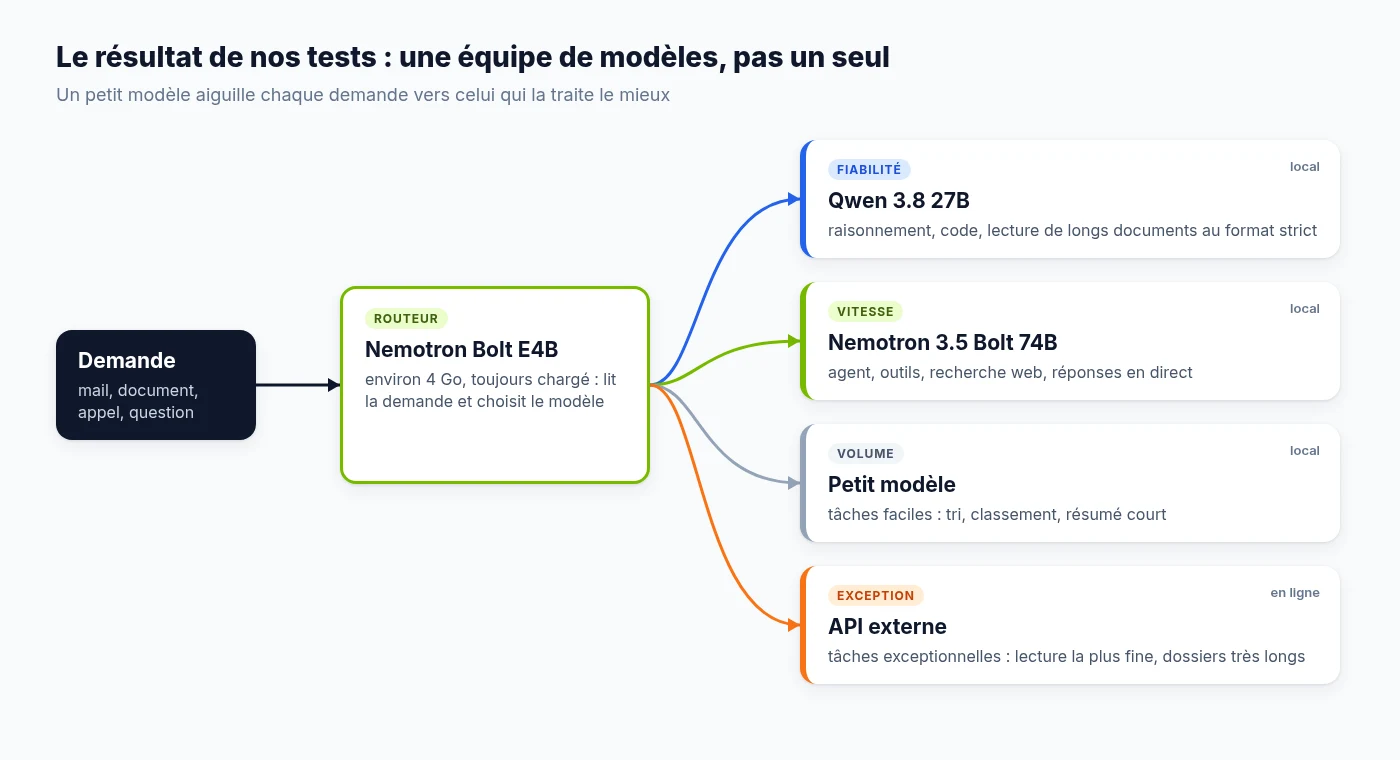
- Un routeur, Nemotron 3.5 Bolt E4B : un tout petit modèle d'environ 4 Go, toujours chargé, qui lit la demande et décide où l'envoyer. NVIDIA l'annonce pour le 23 octobre ; nous le testerons dès sa sortie.
- Qwen 3.8 27B pour le raisonnement, le code et la lecture de longs documents au format strict, comme les comptes rendus de chantier.
- Nemotron 3.5 Bolt 74B pour les agents, les outils, la recherche web et les réponses en direct : c'est là que NVIDIA le classe parmi les meilleurs de sa catégorie (tests PinchBench et BrowseComp), et là que sa vitesse compte.
- Un petit modèle pour les tâches faciles et répétitives : tri, classement, résumé court.
- Une API externe pour les tâches exceptionnelles, comme la lecture la plus fine des PDF scannés ou les dossiers très longs. C'est déjà ce que fait notre client du BTP, avec un modèle local en secours.
Sur une seule carte de 32 Go, Qwen et Nemotron Bolt ne tiennent pas en même temps. Ce type d'architecture se déploie donc sur deux cartes ou deux serveurs, avec le routeur devant.
Questions fréquentes
Pas pour l'instant, en tout cas pas partout. Sur nos tâches de lecture et de classement, Qwen 3.8 reste au moins aussi fiable, et souvent plus. Nemotron est un très bon complément pour les usages où chaque seconde compte, à condition de lui écrire sa propre consigne.
La version Bolt 74B-A9B oui : elle occupe environ 26,5 Go sur une RTX 5090 de 32 Go, contexte compris. La version Super VL (120 milliards de paramètres) demande une station de travail ou un serveur. Une version encore plus légère, Bolt E4B (environ 4 Go), est annoncée par NVIDIA.
Oui, mais pas en même temps sur une carte de 32 Go : à eux deux, ils dépassent la mémoire disponible. Ollama charge alors l'un puis l'autre, ce qui ajoute 5 à 10 secondes à chaque changement. Sur un serveur utilisé en continu, mieux vaut choisir un modèle principal par tâche.
Sur un compte rendu où il donnait une fausse alerte, la réflexion « moyenne » l'a corrigé en « à confirmer », mais le traitement a pris 26 secondes au lieu d'une dizaine. La réflexion complète a pris près d'une minute. Le test sur l'ensemble des 40 comptes rendus reste à faire : sur les 16 premiers, l'accord avec la référence n'était que de 44 %, pour un temps médian de 32 secondes. Nous ne l'utilisons donc pas en production.
Avec un modèle local comme Qwen ou Nemotron, oui : tout est traité sur votre machine, sans envoi dans le cloud. Vous pouvez aussi combiner les deux approches, comme chez notre client du BTP : un modèle en ligne pour les lectures les plus fines, et le modèle local pour le reste et en secours. Pour peser le pour et le contre, lisez cloud ou serveur physique : lequel choisir.
Vous voulez une IA locale, rapide et adaptée à vos vrais documents ? Parlons-en : nous testons chaque modèle sur vos cas réels avant de le mettre en production.