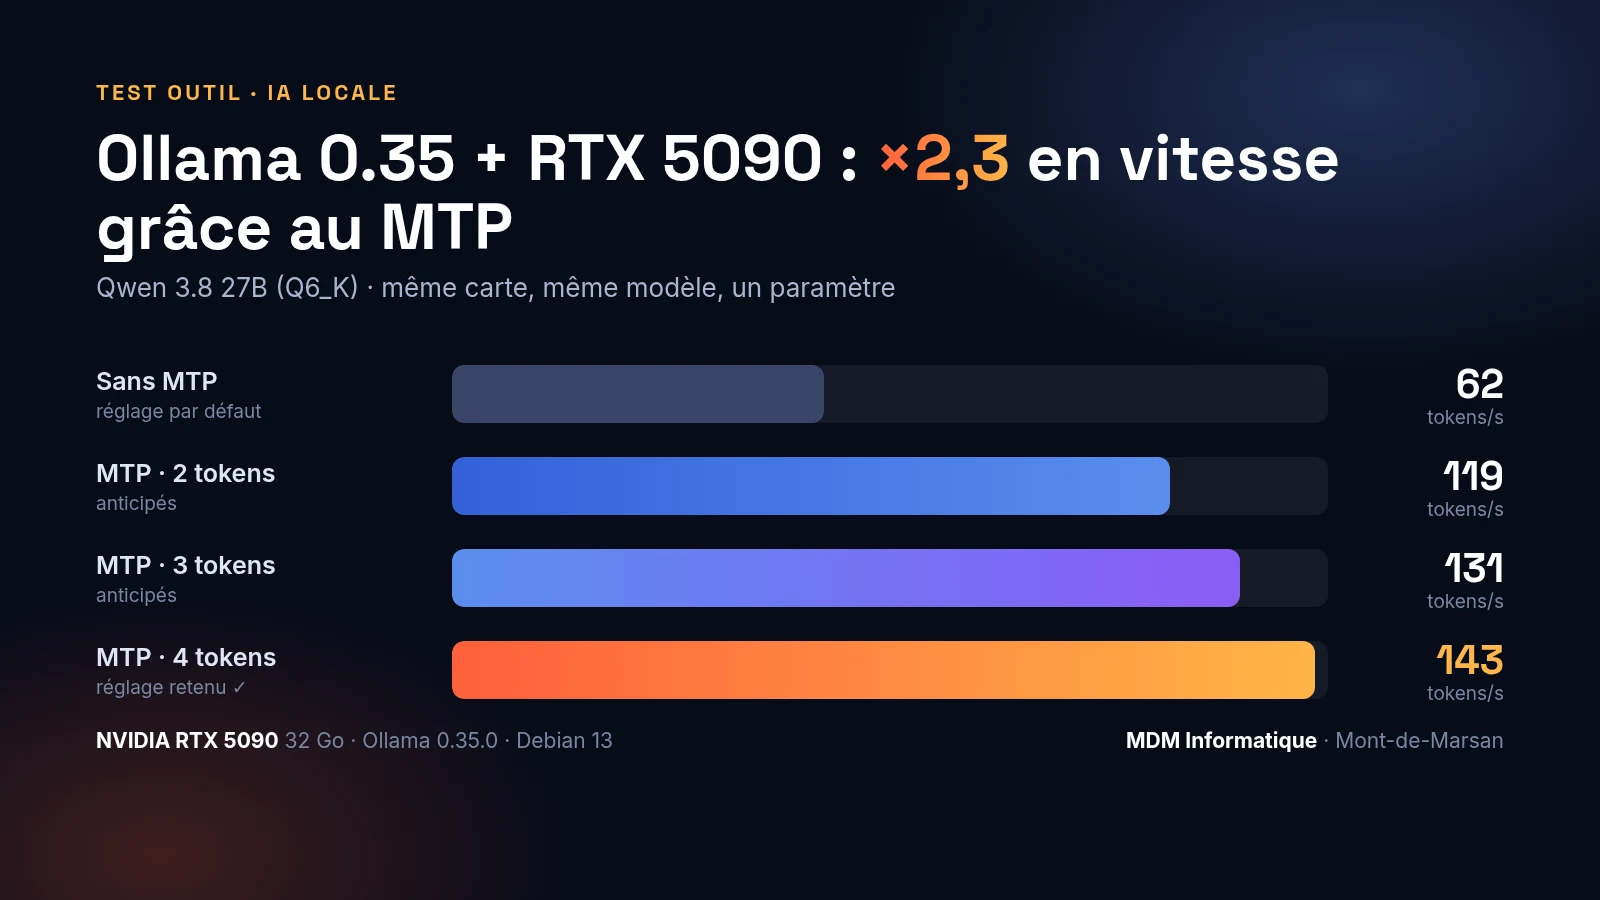
Chez MDM Informatique, notre serveur d'IA tourne en local, dans les Landes, sans envoyer une seule donnée dans le cloud américain. Il rédige, trie les e-mails, prépare les devis et écrit du code tous les jours. En passant à Ollama 0.35.0 sur notre NVIDIA RTX 5090, on a fait passer notre modèle principal de 62 à 143 tokens par seconde. Même carte, même modèle : un seul paramètre a suffi.
Test effectué le 29/09/2026 sur un Intel Core i7-14700K / 64 Go de RAM / système Debian 13, avec une NVIDIA GeForce RTX 5090.
Le banc de test : une RTX 5090 et un modèle de 27 milliards de paramètres
Pour que les chiffres parlent vraiment, on a mesuré sur notre machine de production, celle qui sert nos clients au quotidien :
- Carte graphique : NVIDIA GeForce RTX 5090, 32 Go de VRAM
- Processeur : Intel Core i7-14700K, 64 Go de RAM
- Système : Debian 13
- Moteur d'IA : Ollama 0.35.0 (flash attention activée, cache KV en q8_0)
- Modèle : Qwen 3.8 27B en quantification Q6_K (environ 22 Go), un modèle open source très solide en français
Chaque mesure combine trois tâches représentatives de notre usage réel : rédiger un e-mail client, écrire une fonction Python et extraire des informations en JSON à partir d'un message. Chaque tâche est lancée deux fois, à température 0 puis 0,7, et on retient la médiane. La lecture de prompt est testée sur un document de 23 763 tokens.
Le MTP, ou comment faire écrire l'IA plusieurs mots à la fois
Un modèle de langage écrit normalement un token à la fois : pour chaque morceau de mot, il relit l'intégralité de ses 27 milliards de paramètres. C'est la bande passante mémoire de la carte graphique qui fixe la vitesse, pas sa puissance de calcul.
Les modèles Qwen récents embarquent une petite couche supplémentaire, la tête MTP (Multi-Token Prediction). Elle devine à l'avance les tokens suivants. Le modèle principal vérifie ensuite toutes ces propositions en un seul passage. Quand elles sont justes, plusieurs tokens sortent d'un coup. C'est du décodage spéculatif, sans avoir à charger un second modèle « brouillon » en mémoire.
Le piège : la tête MTP est là, mais Ollama l'ignore
Sur notre modèle Q6_K, la tête MTP est bien présente dans le fichier. Pourtant, Ollama ne s'en servait pas. Le journal du serveur l'indique noir sur blanc au chargement :
model has unused tensor blk.64.nextn.eh_proj.weight -- ignoring
spec common_specu: no implementations specified for speculative decoding
En creusant, on a découvert qu'Ollama 0.35 fait tourner en interne un moteur llama.cpp capable de faire du MTP. Il ne l'active que si le modèle porte un paramètre précis, draft_num_predict. La variante Q4 de Qwen 3.8 distribuée par Ollama l'a déjà. La variante Q6_K, non. Il suffit de l'ajouter :
FROM qwen3.8:27b-q6_K
PARAMETER draft_num_predict 4
PARAMETER num_gpu 99
Puis ollama create qwen3.8:27b-q6_K -f Modelfile. Aucun fichier de modèle n'est retéléchargé : seule la configuration change.
Les résultats : 62 → 143 tokens/s
| Qwen 3.8 27B Q6_K | Génération (T=0) | Génération (T=0,7) | Lecture de prompt |
|---|---|---|---|
| Sans MTP | 61,6 tok/s | 61,5 tok/s | 2 920 tok/s |
| MTP, 2 tokens anticipés | 119,3 tok/s | 120,9 tok/s | 2 700 tok/s |
| MTP, 3 tokens anticipés | 130,6 tok/s | 129,1 tok/s | 2 711 tok/s |
| MTP, 4 tokens anticipés | 142,9 tok/s | 135,8 tok/s | 2 695 tok/s |
| MTP, 5 tokens anticipés | 145,0 tok/s | 133,0 tok/s | 2 687 tok/s |
Avec 4 tokens anticipés, le modèle en accepte en moyenne 3,3 à 3,6 par passage : la génération est 2,3 fois plus rapide. Aller jusqu'à 5 ne rapporte plus rien dès que la température monte, parce que les propositions lointaines sont plus souvent rejetées.
Le gain tient aussi sur les longs documents. Après un prompt de 23 000 tokens, la génération passe de 58 à 131 tokens/s. La contrepartie : la lecture du prompt perd environ 7 % (de 2 920 à 2 700 tokens/s). C'est négligeable face au gain en rédaction.
On a mesuré deux autres modèles installés sur le même serveur, dans les mêmes conditions :
- Qwen 3.8 27B en Q4_K_M (MTP déjà activé par Ollama) : environ 160 tokens/s. Plus rapide que le Q6_K, au prix d'une précision un peu moindre.
- Qwen 3.6 35B-A3B, un modèle « MoE » qui n'active que 3 milliards de paramètres par token : 221 tokens/s sans MTP… et seulement 196 avec.
La leçon : sur un modèle MoE, déjà très léger à chaque étape, vérifier les propositions coûte plus cher que ce qu'elles font gagner. Le MTP est à réserver aux modèles denses, comme notre 27B.
Non. Chaque token proposé par la tête MTP est validé par le modèle principal avant d'être gardé. La qualité reste celle du modèle Q6_K. En comparant les sorties à température 0, le texte peut légèrement diverger au bout de quelques phrases, à cause de minuscules différences de calcul, mais le fond et le niveau de langue sont identiques.
Un peu : environ 1,2 Go de VRAM en plus. Sur nos 32 Go, partagés avec un modèle de transcription audio, le répartiteur automatique d'Ollama renvoyait 2 couches sur 66 vers le processeur, ce qui annulait une partie du gain. Le paramètre num_gpu 99 force tout le modèle sur la carte graphique ; le cache du MTP est aussi passé en q8_0 pour gagner de la place.
Sur GitHub, la 0.35.0 est encore marquée comme pré-version ; la dernière stable est la 0.34.4. On l'a installée en gardant une sauvegarde complète de l'ancienne version, prête pour un retour arrière. Depuis sa mise en production, aucun problème à signaler. Nous avons aussi ajouté un garde-fou qui remet automatiquement le paramètre MTP si le modèle est réinstallé.
Ce qu'il faut retenir
- Un seul paramètre (
draft_num_predict) a fait passer notre IA de 62 à 143 tokens/s sur une RTX 5090. - Vérifiez vos journaux : le message « unused tensor … nextn … ignoring » signifie que votre modèle a une tête MTP inutilisée.
- 4 tokens anticipés, c'est le meilleur réglage dans notre cas.
- Pas de MTP sur les modèles MoE : il les ralentit.
- Surveillez la VRAM : il faut environ 1,2 Go de marge supplémentaire.
Avant d'investir dans du matériel plus puissant, vérifiez que votre logiciel exploite vraiment tout ce que vos modèles savent faire. Vous voulez une IA locale, rapide et hébergée en France pour votre entreprise ? Parlons-en : c'est exactement ce que nous déployons chez nos clients.